
事件补偿示例
compensation 是可运行的 Wow 应用和运营控制台。本页只负责运行与运营验证;即时重试、ExecutionFailed 状态机和重放语义见事件补偿指南,完整属性见事件补偿配置。
模块与验证基线
| 模块 | 运行职责 |
|---|---|
wow-compensation-api | 命令、事件、状态与查询契约 |
wow-compensation-domain | ExecutionFailed 聚合与退避计算 |
wow-compensation-core | 失败捕获、结果写回与原事件重放 |
wow-compensation-server | 快照查询、调度、OpenAPI、通知,以及存在前端构建产物时的 Dashboard 托管 |
dashboard | 补偿态势、失败队列、详情与人工操作 |
先验证领域、核心与控制台:
./gradlew :wow-compensation-domain:check :wow-compensation-core:check
pnpm --filter wow-compensation-dashboard^... build
pnpm --dir compensation/dashboard exec vitest run
ExecutionFailedSpec 覆盖 prepare、force prepare、成功、再次失败和规格变更;CompensationFilterTest 覆盖过滤器错误边界;Dashboard 测试覆盖队列条件与操作状态。命令成功只证明这些本地 gate,不证明真实消息、存储、通知或部署环境。
本地服务启动、健康与路由验证
当前 :wow-compensation-server:run 的默认 JVM 参数会在 5555 开启无认证、无 TLS 的 JMX。最小安全的本地路由验证先生成 distribution,再用普通 java 只绑定 loopback。installDist 只复制已经存在的 compensation/dashboard/dist,不会构建前端;当前端产物不存在时,这条流程不验证 Dashboard 静态资源。
./gradlew :wow-compensation-server:installDist

SERVER_PORT=18083 \
SERVER_ADDRESS=127.0.0.1 \
SPRING_AUTOCONFIGURE_EXCLUDE='org.springframework.boot.elasticsearch.autoconfigure.ElasticsearchClientAutoConfiguration,org.springframework.boot.elasticsearch.autoconfigure.ElasticsearchRestClientAutoConfiguration,org.springframework.boot.data.redis.autoconfigure.DataRedisReactiveAutoConfiguration,org.springframework.boot.mongodb.autoconfigure.MongoAutoConfiguration,org.springframework.boot.mongodb.autoconfigure.MongoReactiveAutoConfiguration' \
COSID_MACHINE_DISTRIBUTOR_TYPE=manual \
COSID_MACHINE_DISTRIBUTOR_MANUAL_MACHINE_ID=1 \
WOW_COMPENSATION_SCHEDULER_ENABLED=false \
WOW_COMPENSATION_WEBHOOK_WEIXIN_URL=false \
WOW_KAFKA_ENABLED=false \
WOW_COMMAND_BUS_TYPE=in_memory \
WOW_EVENT_BUS_TYPE=in_memory \
WOW_EVENTSOURCING_STATE_BUS_TYPE=in_memory \
WOW_EVENTSOURCING_STORE_STORAGE=in_memory \
WOW_EVENTSOURCING_SNAPSHOT_STORAGE=in_memory \
WOW_PREPARE_ENABLED=false \
WOW_MONGO_ENABLED=false \
WOW_REDIS_ENABLED=false \
WOW_ELASTICSEARCH_ENABLED=false \
java \
  -Dspring.config.location=file:compensation/wow-compensation-server/src/main/resources/application.yaml \
  -cp 'compensation/wow-compensation-server/build/install/wow-compensation-server/lib/*' \
  me.ahoo.wow.compensation.server.CompensationServerKt
预期日志包含 Netty started on port 18083 和 Started CompensationServerKt。在另一个终端验证同一地址与端口:
curl -fsS http://127.0.0.1:18083/actuator/health/liveness
curl -fsS http://127.0.0.1:18083/v3/api-docs | \
  jq -r '.paths["/execution_failed/{id}/prepare_compensation"].put.operationId'
预期分别得到 {"status":"UP"} 和 compensation.execution_failed.prepare_compensation。这组检查只验证服务启动、健康端点和 prepare 路由存在;它没有请求 Dashboard 静态资源,也没有发送补偿命令或执行状态转换,因此不验证 Dashboard 或本地状态机。该模式还会在进程退出后丢失数据并禁用自动调度,不是持久恢复证明。
Dashboard 需要单独启动并验证:
pnpm --filter wow-compensation-dashboard^... build
pnpm --dir compensation/dashboard dev
补偿控制面
控制台建在 Wow 视图引擎(@ahoo-wang/wow-view-engine)上:统计、列表、筛选、分页、导出、详情抽屉与图表都是引擎的,控制台只声明补偿的定义(字段、系统视图、系统板,见 compensation/dashboard/src/views/)并挂上领域命令。数据直接来自现有查询路由,不引入专用统计后端:
- Snapshot:
POST /execution_failed/snapshot/{paged,aggregation}; - EventStream:
POST /execution_failed/event/{paged,aggregation}; - 能力描述:
GET /execution_failed/{snapshot,event}/schema。控制台先读它,再按服务端实际支持的算子、排序、分组与上限收窄定义:没列出的能力不出现在界面上,也就不会发出注定被拒的查询。
| 地址 | 页面 |
|---|---|
/ | 「总览」:系统板「补偿概览」,嵌入在首页,只读不存 |
/executions | 「失败执行」:记录与分析的工作台,七个队列是它的系统视图 |
/events | 「事件流」:补偿事件流的工作台(概览上事件流面板的「在工作台中打开」落在这里) |
/boards | 「看板」:仪表盘工作台,另存、改排、搭自己的板 |
四个去处都在顶栏;旧的队列地址(/to-retry 等)与 /dashboard、/analytics 已随旧外壳去掉,打开会回到总览。通知里的链接指向 /executions?view=…&id=…。
如何读取概览
| 面板 | 回答的问题 | 统计口径 |
|---|---|---|
| 范围内活动/全部活动 | 失败积压有多大,所选时间覆盖了多少 | 活动 = FAILED / PREPARED;「范围内」受时间范围约束,「全部」不受 |
| 可立即处理/已超时/不可恢复 | 现在有多少能处理、卡住、放弃 | 「可立即处理」即「已到重试时间」队列;「已超时」是 PREPARED 且 timeoutAt 早于服务端的此刻 |
| 新增失败/准备重试/重试失败/重试成功 | 流入与结局 | 含该事件的事件流数,带每日走势,数字是整个范围之和 |
| 净积压/重试成功率 | 是否在改善 | 新增失败 − 重试成功;重试成功 / (重试失败 + 重试成功),由服务端按事件名计数后算出 |
| 失败集中度 · 前 5 个集群 | 压力集中在哪里 | 上下文 × 处理器 × 函数 × 错误码(省去由前三者决定的函数类型),带活动失败数、最早执行与最早下次重试;「在工作台中打开」进「失败集中度」视图,五维身份与按状态拆开的全部列;点一行进「活动中」视图并带着这一组与时间范围作条件 |
| 活动失败的可恢复性/重试次数 | 当前记录是否可恢复、已重试多少次 | 所选范围内的活动快照,重试分 0、1–2、3–5、6+ 四档 |
| 最需要处理 · 已到重试时间 | 该先处理哪几条 | 按下次重试时刻升序;行上与勾选后的命令与「失败执行」一致 |
时间范围是板上唯一的筛选,缺省「近 7 天」(今天与之前 6 个整天),同时约束 Snapshot 的 state.executeAt 与 EventStream 的 createTime;筛选值记在这一条浏览记录里。「更新于」是屏上各面板里最早读到的时刻,旁边的刷新按钮重读整块板;一块面板失败只在它自己里面说原因。任何面板都能铺满屏幕。
这些数字是运营信号,不是业务对账或恢复完成证明。Prepared 只表示已进入重放准备状态,Succeeded 只表示目标函数本次补偿成功;外部副作用仍需按稳定幂等键核对。
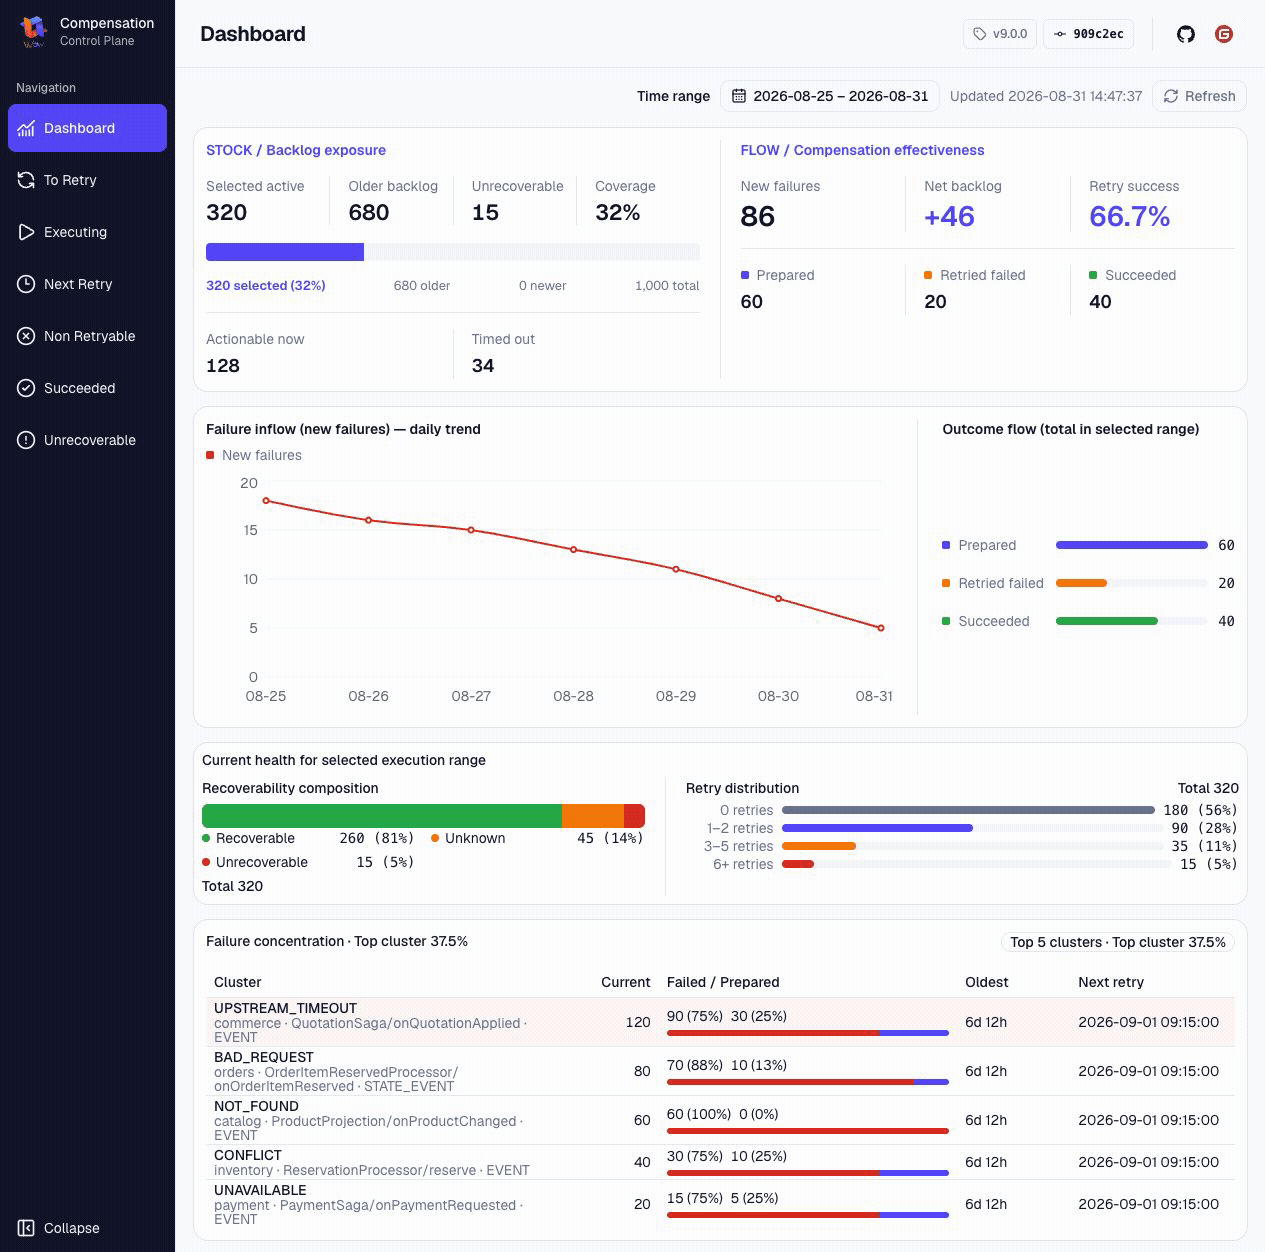
截图来自对真实补偿服务(MongoDB 存储)的浏览器渲染,数据是本地写入的演示数据,不是生产指标。
队列、筛选与人工操作
「失败执行」的系统视图:
| 视图 | 条件 |
|---|---|
| 活动中 | FAILED / PREPARED |
| 待重试 | RECOVERABLE / UNKNOWN、低于重试上限,且为 FAILED 或已超时的 PREPARED |
| 执行中 | 尚未超时的 PREPARED(timeoutAt 不早于服务端的此刻) |
| 已到重试时间 | 待重试的记录里 nextRetryAt 已到的,即自动调度的候选 |
| 不可重试 | 已达到普通重试上限的活动记录 |
| 不可恢复 | UNRECOVERABLE 的活动记录 |
| 已成功 | SUCCEEDED 历史记录 |
| 全部,以及四张分析 | 按状态分布、活动失败按处理器、每日新增失败、失败集中度(概览集群面板的全部列) |
「此刻」由服务端在每次查询时读自己的时钟(BEFORE_NOW / AFTER_NOW,需要 Wow 9.2.0 及以上的服务端),与命令侧的超时判断同一口径。
- 筛选:定义里的任意字段按其种类的运算符组合(与/或/取反);「搜索错误」是错误信息与堆栈的全文检索,只在存储支持时出现——Elasticsearch 快照存储可用,MongoDB 快照存储要在集合上建文本索引才会在能力描述里出现。
- 视图:列、排序、卡片布局与条件可以另存为个人视图。个人视图存在这台电脑的这个浏览器里(
localStorage),同事看不到。 - 导出:按当前条件或勾选导出 CSV,缺省中和公式。
- 详情:点一行(或回车)从侧边打开,按字段分组读全,并附堆栈(行号、换行、复制)、「变更函数」「应用重试规格」两份表单与执行历史;执行历史里的一行再打开这一次事件的完整载荷。打开的是哪一条写在地址的
?id=里,可以当链接发出去。
可用操作(每行、详情头部与勾选后的工具栏):
- 准备(Prepare compensation):普通准备,受状态、超时和重试上限约束;
- 强制准备(Force prepare):经确认越过重试上限,但不越过成功状态或未超时的
PREPARED; - 标记可恢复性(Mark recoverable):修改恢复性并改变自动调度资格;
- 应用重试规格(Apply retry spec):修改非负的
maxRetries、minBackoff与executionTimeout; - 变更函数(Change function):修改 context、processor、函数名与
EVENT/STATE_EVENT类型。
成批命令先确认(写明条数,并列出控制台已知不会发送的记录及原因),每次 4 条并发地发出,等到快照写入再返回(Command-Wait-Stage: SNAPSHOT);进度可停,服务端拒绝的记录带着服务端的原因仍保持勾选。按钮是否可用只是提示,服务端状态机才是最终决定。
当前 UI 不提供删除或恢复已删除聚合的按钮,也没有定义运营角色、审批流或审计保留策略。部署方必须在网络、认证、授权与审计层提供这些控制。
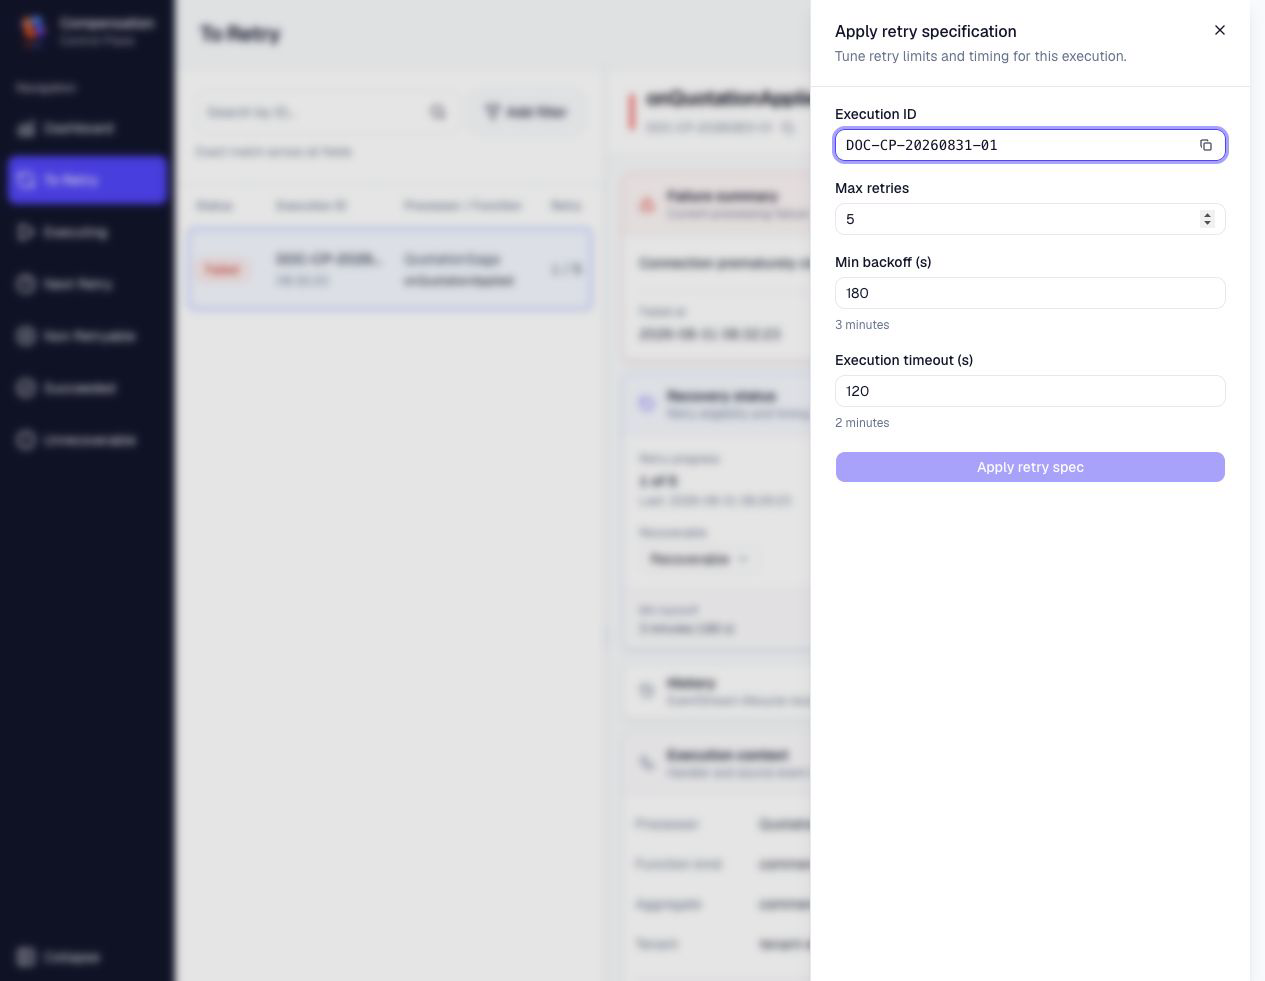
截图同样来自对真实服务的渲染;操作是否成立仍由服务端状态机决定。
管理端点
Dashboard 的生成客户端当前使用空 basePath,默认命令路由为:
| 操作 | 路由 |
|---|---|
| 普通准备 | PUT /execution_failed/{id}/prepare_compensation |
| 强制准备 | PUT /execution_failed/{id}/force_prepare_compensation |
| 修改重试规格 | PUT /execution_failed/{id}/apply_retry_spec |
| 修改恢复性 | PUT /execution_failed/{id}/mark_recoverable |
| 修改目标函数 | PUT /execution_failed/{id}/change_function |
API Gateway 可以在外部添加 context 前缀;运行实例的 OpenAPI 是最终路由证据。生成客户端还包含默认聚合删除与恢复路由,但当前 Dashboard 不调用它们。
对一个已存在且可重试的失败记录执行普通准备:
curl -X PUT \
  'http://127.0.0.1:18083/execution_failed/<execution-id>/prepare_compensation' \
  -H 'Command-Wait-Stage: PROCESSED' \
-H 'Command-Request-Id: prepare-<execution-id>'succeeded=true、stage=PROCESSED 只证明 prepare 命令已处理。随后读取可能仍看到旧 FAILED、短暂 PREPARED,或已经看到最终 SUCCEEDED / 新的 FAILED。若要观察完整结果,应轮询 snapshot/event 查询并核对状态事件历史,而不是对一次即时读取断言。
失败路径也要验证:普通 prepare 拒绝 SUCCEEDED、未超时的 PREPARED 和达到上限的记录;force prepare 仍拒绝成功或未超时状态;对非 PREPARED 直接 apply success/failure 会返回 ExecutionFailed is not prepared.。Dashboard 按钮只是操作提示,服务端状态机才是最终决定。
通知验证
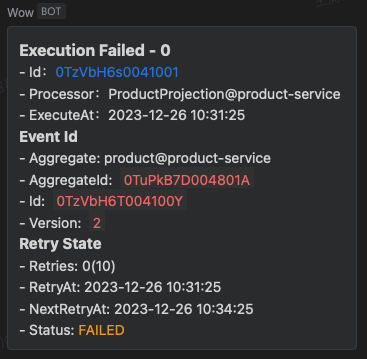
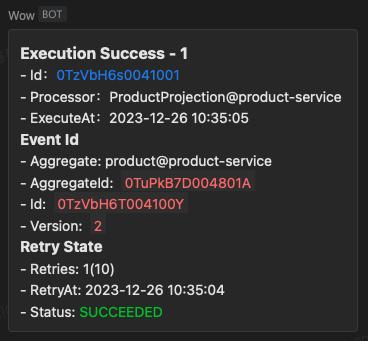
配置企业微信后,以受控失败和成功事件分别验证机器人消息、快速导航链接与敏感信息边界。WebHook 发送成功只证明通知可达,仍需在 Dashboard 或查询结果中核对权威状态。
| 失败通知 | 成功通知 |
|---|---|
 |  |
持久化部署与验证
持久化环境继续使用 distribution 的直接 java 启动路径,配置真实 MongoDB、Redis、Kafka、scheduler 与通知,然后移除本地示例中的 in-memory / disable 覆盖。仓库提供服务宿主和 Dashboard 构建,不提供可直接投产的集群策略。
最小 Kubernetes 形状如下;镜像摘要、资源、副本与 Secret 名称必须由实际发布和容量验证决定:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: compensation-service
spec:
  replicas: 2
  selector:
    matchLabels:
      app: compensation-service
  template:
    metadata:
      labels:
        app: compensation-service
    spec:
      containers:
        - name: compensation-service
          image: <registry>/wow-compensation-server@sha256:<digest>
          envFrom:
            - secretRef:
                name: wow-compensation-secrets
          ports:
            - name: http
              containerPort: 8080
          readinessProbe:
            httpGet:
              path: /actuator/health
              port: http
          livenessProbe:
            httpGet:
              path: /actuator/health
              port: http
部署验证至少包括:
- 固定选定 Wow tag 构建的不可变镜像摘要,并在测试与生产使用同一摘要;
- 通过 Secret 注入消息、存储、通知与认证凭据;
- 验证 EventStore 与 SnapshotStore 的索引、容量、备份和恢复;
- 验证 readiness/liveness、scheduler 互斥、积压、失败年龄、重启数与错误日志;
- 将 Dashboard 与管理端点限制在受保护的运营网络,启用 TLS、认证、细粒度授权和审计;
- 在测试环境走通正常、可重试、不可恢复、幂等和人工恢复,再推广同一镜像。
replicas: 2 本身不证明高可用;多个副本还依赖消息、存储和 scheduler 互斥的真实故障验证。